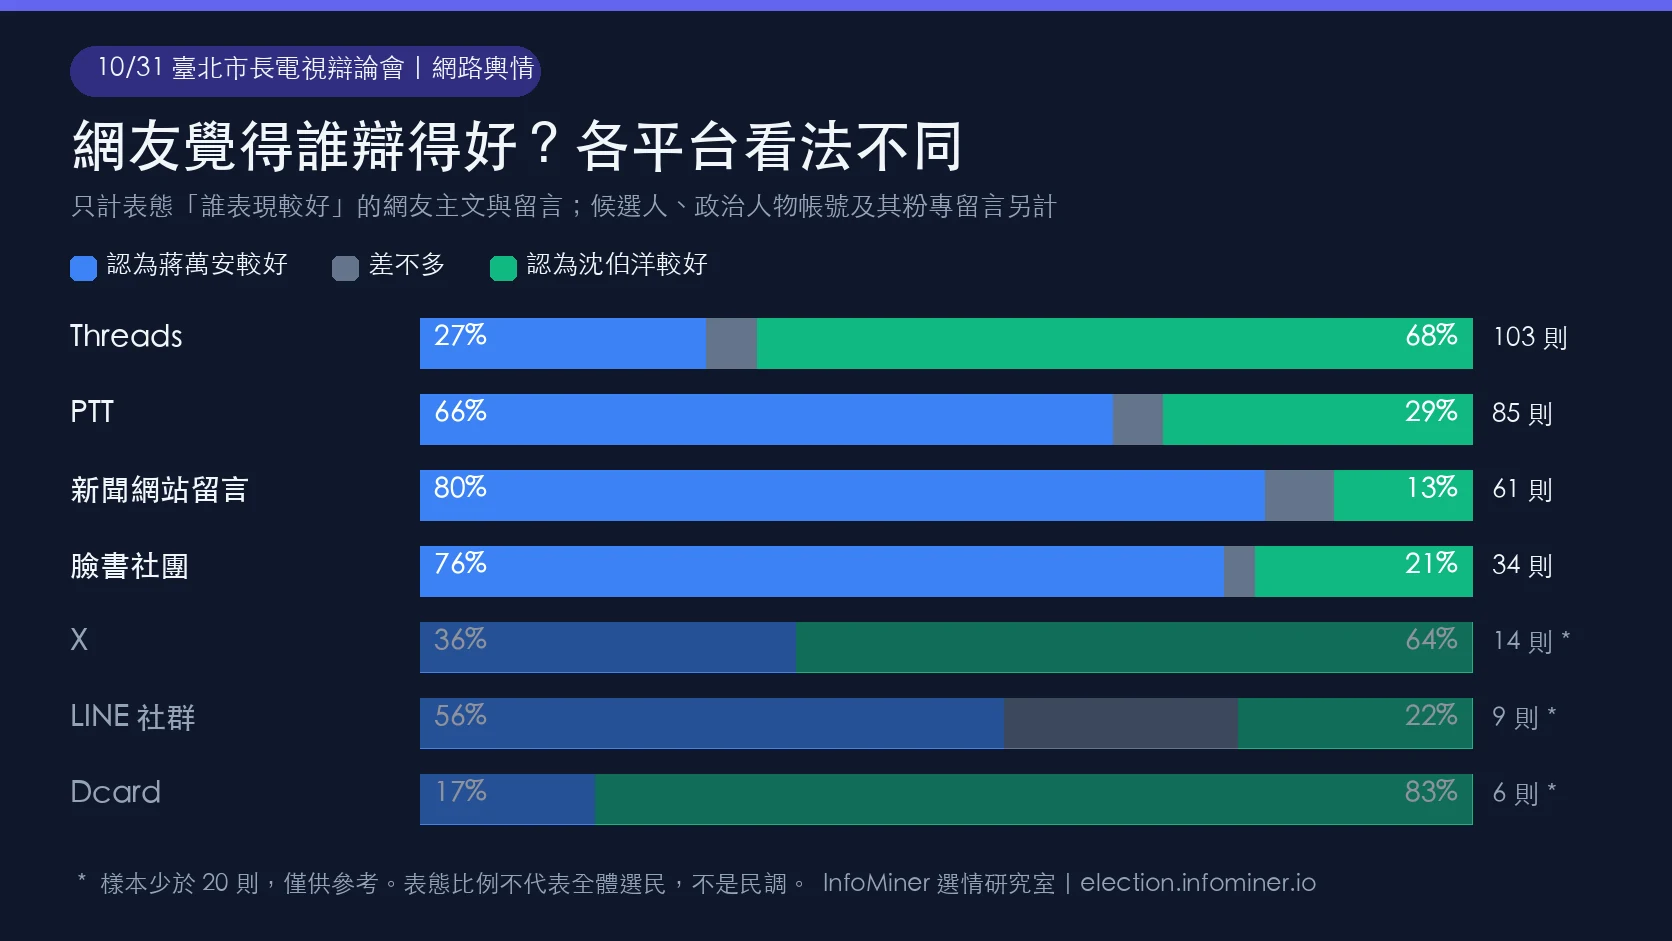
先講結論:網友看法依平台分邊
10 月 31 日下午,國民黨籍台北市長蔣萬安與民進黨台北市長參選人沈伯洋舉行電視辯論會。我們用 InfoMiner 蒐集辯論當天中午到傍晚 6 時的公開討論,去重後依平台抽樣 899 則主文與留言,逐則標註「作者認為誰表現較好」,再把討論內容分群。
結果沒有一面倒。Threads 上表態的網友多認為沈伯洋表現較好;PTT、新聞網站留言區與臉書社團則多認為蔣萬安較好。表態幾乎與作者可辨識的支持立場一致,看不出明顯支持立場的網友多半沒有評論輸贏。
若把各平台樣本直接相加,表態者中約 55% 認為蔣萬安較好、40% 認為沈伯洋較好、5% 認為差不多。但這個合計會隨各平台抽多少樣本而變動,換一種抽樣比例結果就不同,所以我們不以合計數字判定誰贏,而是把各平台分開呈現。
各平台網友怎麼看
下表只計「網友」的主文與留言:包含 PTT、Threads、Dcard、臉書社團、X、LINE 社群的發文,以及各平台貼文底下的留言。候選人與政治人物帳號的發文、政治人物粉專底下的留言、只是轉述媒體或名人評價的內容,都另外計算,不放進這張表。
| 平台 | 網友樣本 | 有表態 | 認為蔣萬安較好 | 認為沈伯洋較好 | 差不多 |
|---|---|---|---|---|---|
| Threads(主文+留言) | 151 | 103 | 28(27%) | 70(68%) | 5 |
| PTT(主文+推文) | 137 | 85 | 56(66%) | 25(29%) | 4 |
| 新聞網站留言(多為 Yahoo 新聞) | 112 | 61 | 49(80%) | 8(13%) | 4 |
| 臉書社團 | 49 | 34 | 26(76%) | 7(21%) | 1 |
| X(Twitter) | 16 | 14 | 5 | 9 | 0 |
| LINE 社群 | 12 | 9 | 5 | 2 | 2 |
| Dcard | 10 | 6 | 1 | 5 | 0 |
| 合計 | 487 | 312 | 170(54%) | 126(40%) | 16(5%) |
百分比以「有表態」為分母。X、LINE 社群與 Dcard 的表態樣本少於 20 則,只列次數,不計比例。另有 175 則網友內容與辯論相關,但沒有評論誰表現較好,例如只討論政見、轉貼片段或詢問直播連結。
Threads 與 PTT 是樣本中網友表態最多的兩個平台,結論卻相反;這和高雄場不同,高雄場兩個平台都是認為民進黨候選人較好的比例較高(見高雄市長辯論網友反應分析)。
評價幾乎跟著支持立場走
標註時,我們另外請模型判斷作者「從用語、立場、攻擊對象可明顯看出」的支持傾向,並要求不能用輸贏評價反推。交叉後可以看到,認為誰表現較好,幾乎等於原本支持誰:
| 作者可辨識的傾向 | 樣本 | 認為蔣萬安較好 | 認為沈伯洋較好 | 差不多 | 未表態 |
|---|---|---|---|---|---|
| 看得出支持蔣萬安陣營 | 218 | 151 | 0 | 2 | 65 |
| 看得出支持沈伯洋陣營 | 160 | 4 | 121 | 2 | 33 |
| 看不出明顯傾向 | 109 | 15 | 5 | 12 | 77 |
看得出傾向的網友中,評價和自己陣營相反的不到 2%。看不出明顯傾向的 109 則裡,只有 32 則評論了輸贏,其中認為差不多的比例明顯較高;但 32 則太少,不足以代表「中間選民」怎麼看。
傾向判斷本身也有限制:模型可能因為一則內容稱讚某位候選人,就判定作者支持他。即使把這點納入考量,各平台的差異仍主要反映哪個陣營的支持者聚集在哪個平台,而不是同一群人看完辯論後的評價分歧。
網友在討論什麼:分群與各群立場
我們把 793 則與辯論相關的內容,依文字相似度分成 18 群(另有 36 則無法歸群),再由語言模型依各群的關鍵詞與內容命名。下表的立場只計網友內容;同一群裡常同時有雙方支持者,分群代表討論主題,不代表立場。
| 討論群 | 相關內容 | 網友:蔣較好 | 網友:沈較好 | 差不多 |
|---|---|---|---|---|
| 市政熟悉度與都更交鋒 | 115 | 11 | 15 | 1 |
| 辯論整體勝負 | 82 | 29 | 9 | 4 |
| 開場定調與互相攻擊 | 76 | 19 | 16 | 1 |
| 二次辯論邀約 | 56 | 7 | 3 | 1 |
| 答非所問與市政會議出席率 | 55 | 21 | 13 | 3 |
| 政見具體度(都更「陪伴」、種樹) | 52 | 20 | 4 | 1 |
| 直播觀看數與主持人反應 | 41 | 7 | 2 | 0 |
| 低頭看稿與背稿 | 37 | 4 | 26 | 1 |
| 口條與台風 | 36 | 11 | 7 | 0 |
| 選情預測與兩場辯論比較 | 34 | 13 | 4 | 4 |
| 結辯內容 | 29 | 1 | 4 | 0 |
| 媒體提問與洩題質疑 | 28 | 5 | 7 | 0 |
| 電視台聲明與轉播彈幕 | 27 | 0 | 0 | 0 |
| 財劃法與雙城論壇 | 26 | 2 | 1 | 0 |
| 風度與口頭禪 | 25 | 1 | 4 | 0 |
| 雙方辯論策略 | 22 | 5 | 4 | 0 |
| 其他 2 個小群 | 16 | 5 | 3 | 0 |
「相關內容」包含媒體與名人貼文,所以會大於右側網友表態的加總。各群的網友表態有兩個方向:
- 認為蔣萬安較好的比例較高:辯論整體勝負、政見具體度、答非所問與會議出席率、選情預測。這些群的論點集中在沈伯洋的政見不夠具體、對市政不熟,以及蔣萬安的臨場表現。
- 認為沈伯洋較好的比例較高:低頭看稿與背稿、結辯內容。論點集中在蔣萬安看稿、答非所問,以及沈伯洋的語氣與結論。
- 兩邊接近:市政熟悉度與都更交鋒、開場互相攻擊、媒體提問。同一段攻防,雙方支持者各自解讀為己方得分。
各群的代表性說法
以下從各群的網友內容中,各選一則認為蔣萬安較好與一則認為沈伯洋較好的原文,只節錄並調整空白與標點,不改寫。選取原則是論點清楚,排除純粹人身攻擊的內容;同一群內雙方的則數不同,各選一則不代表雙方聲量相當。
| 討論群 | 認為蔣萬安較好 | 認為沈伯洋較好 |
|---|---|---|
| 市政熟悉度與都更 | 「蔣談論的全是實質的市政內容,沈則像文青一樣天馬行空」(X) | 「蔣萬安在辯論會上的表現,是用『昨天的政績』來逃避『明天的挑戰』」(Dcard) |
| 辯論整體勝負 | 「兩邊都在避答對自己不利的問題,所以蔣萬安是沒有什麼失分的。沈伯洋想要把這場辯論導向一個市政的辯論,很顯然他並沒有成功」(PTT) | 「我覺得沈伯洋辯論保持溫和很聰明」(PTT) |
| 開場與互相攻擊 | 「蔣市長一上來就火力全開,太會酸!」(Threads) | 「今天辯論一開始蔣萬安就一路攻擊沈,彷彿沈是現任市長,蔣是挑戰者」(PTT) |
| 答非所問與出席率 | 「雙方分明都對自己不想回答的問題進行迴避,但……覺得這次殺傷力最強的應該是,蔣萬安9個實例」(Dcard) | 「萬安講的東西一樣都是問A答B……在講時不停低頭看稿」(PTT) |
| 政見具體度 | 「沈伯洋給我的感覺就是滿嘴空話,講出一堆政見問題,卻不講實際可以解決的辦法」(臉書社團) | 「蔣萬安為什麼不乾脆把他背的稿子直接放網上就好」(X) |
| 低頭看稿 | 「人家在聽內容思考內容,啊妳在數低頭」(Threads 留言) | 「光申論8分鐘,蔣萬安就低頭51次」(Threads,網友自行計數) |
| 口條與台風 | 「蔣萬安從頭到尾都笑……大家看的是你對外的談吐、儀容」(PTT) | 「蔣萬安看起來像是受訓參加辯論賽的辯士,聲調高亢、充滿表演性」(Threads) |
| 結辯 | 「蔣萬安這一段封神了」(臉書社團) | 「這場辯論最好看的,就是最後六分鐘沈伯洋的結論」(Threads) |
也有網友認為兩人差不多,例如 PTT 上的「蔣沒想像中弱,沈也沒網路吹的強」,以及「兩邊都在避答對自己不利的問題」。
媒體、名人與政治人物頁面另計
以下內容和辯論有關,但不是一般網友的評價,所以不放進前面的網友統計:
- 媒體與公眾人物發文(新聞報導、臉書粉專、YouTube、TikTok 頻道)196 則:37 則評價蔣萬安較好、28 則評價沈伯洋較好、3 則認為差不多,其餘 128 則只報導、不評價。
- 候選人與政治人物本人帳號 13 則:兩位候選人辯論後都在 Threads 發文說明自己的論點,另有其他政治人物、媒體與 AI 帳號的發文。
- 政治人物粉專底下的留言 83 則,全部來自國民黨立委洪孟楷的粉專:66 則認為蔣萬安較好、9 則認為沈伯洋較好。這類留言區主要是該政治人物的支持者,若混進網友統計,會讓「臉書粉專」一欄幾乎一面倒,所以獨立列出。
- 轉述他人評價 27 則:網友轉貼名嘴或學者的評價,依標註原則不算作者本人的看法。
資料與方法
- 蒐集:以 InfoMiner 搜尋「(蔣萬安 OR 沈伯洋)且含『辯論』」,時間為 10 月 31 日中午 12 時至傍晚 6 時,共 4,424 則公開主文。
- 過濾與去重:排除中國大陸與香港媒體來源 150 則;完全相同內容 822 則、過短 85 則、高度相似(文字重疊 80% 以上)479 則,剩 2,888 則不重複主文。
- 依平台抽樣主文:每個平台取互動數最高的 30 則加隨機 30 則,不足 60 則的平台全取,共 419 則。
- 抽樣留言:每個平台取互動最高、且有留言的貼文最多 15 篇(同一作者最多 3 篇)抓取留言,共 10,768 則不重複留言;PTT、Threads、新聞網站、臉書粉專各隨機抽 120 則,共 480 則。
- 標註:由語言模型逐則判斷是否與辯論有關、作者認為誰表現較好、可辨識的支持傾向與討論主題。人工抽查 60 則,約 9 成判斷一致。
- 分群:以中文斷詞 TF-IDF 計算相似度,再用 Louvain 社群偵測分群,並由語言模型命名。
完整的方法、各步驟參數與限制,請見大數軟體的辯論輿情分析方法論。
讀數字前先知道的限制
- 這不是民調。網路上主動發言的人不代表全體選民,各平台使用者的政治傾向本來就不同。
- 資料只到辯論當天傍晚 6 時,是辯論後數小時的快照;之後的討論、剪輯影片帶起的第二波聲量沒有納入。
- 臉書、YouTube、TikTok 多數貼文的留言無法透過 API 取得,這三個平台的網友留言幾乎沒有進入樣本;臉書社團只有主文。
- Threads 與 PTT 的留言集中在少數高互動貼文底下,會受發文者立場影響。
- 模型標註約有 1 成與人工判斷不同;反諷、梗圖文字與只有表情符號的內容最容易判錯。
- 我們無法判斷帳號是否為真人,也沒有排除可能的協同發文。
資料來源
- InfoMiner 全網輿情資料庫:新聞網站、PTT、Dcard、Threads、臉書粉專與社團、YouTube、TikTok、X、LINE 社群的公開內容,2026 年 10 月 31 日 12:00 至 18:01。
- 標註與分群:大數軟體 LargitData 研究團隊。